近日,宋鑫明为第一作者、戴鸿君教授为通讯作者、与邱美康合作的论文《Adaptive Thread Scheduling and Optimization Framework for the Multi-Core CPU with Large-Capacity Cache》被 ACM Transactions on Architecture and Code Optimization(ACM TACO)正式接收。ACM TACO 由国际计算机学会(ACM)出版,主要面向计算机体系结构与代码优化,涵盖处理器体系结构、编译与运行时优化、存储系统以及软硬件协同优化等方向,是计算机体系结构领域具有重要影响力的国际期刊,也是中国计算机学会(CCF)推荐的A类期刊。
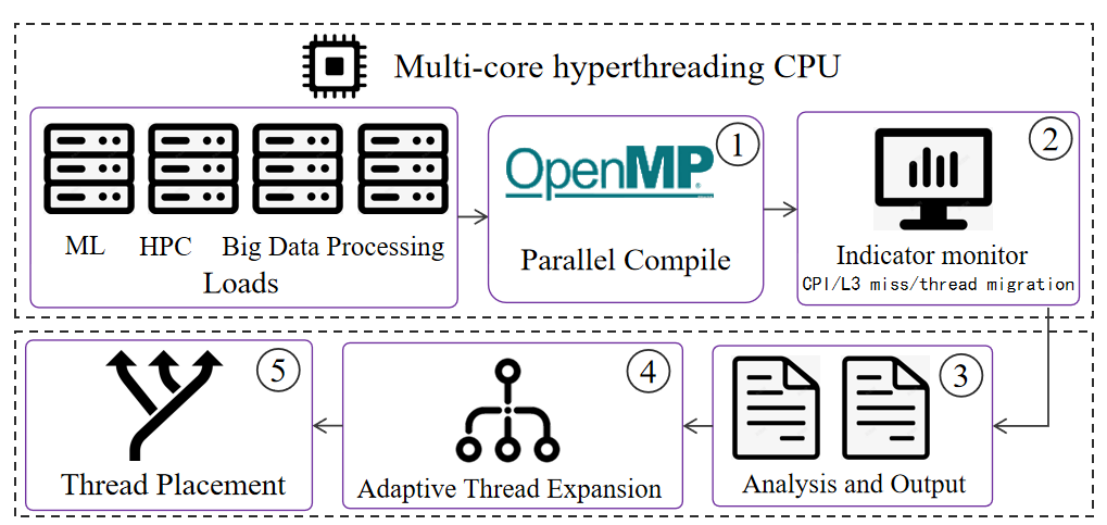
论文聚焦于大容量缓存多核处理器中的线程调度与缓存竞争问题。随着处理器计算能力持续提升,主存访问延迟与处理器执行速度之间的差距不断扩大,“内存墙”(Memory Wall)问题日益突出。大容量缓存能够有效缓解存储访问瓶颈,但传统线程调度策略缺乏对处理器硬件拓扑和缓存资源竞争的充分感知,容易引发频繁的线程迁移和缓存争用。针对这一问题,论文提出了一种面向大容量缓存多核CPU的自适应线程调度与优化框架,通过动态监测线程运行状态,并结合线程规模调整与拓扑感知的线程放置策略,提高缓存利用效率和线程调度稳定性。
该框架通过线程与CPU监测(TCM)机制实时分析线程调度行为和缓存性能,并分别针对同步多线程(SMT)开启和关闭场景识别系统性能瓶颈。在此基础上,线程扩展与放置(TEP)算法结合三次样条插值和黄金分割法,根据运行时性能变化自适应调整线程规模,同时结合处理器核心与缓存拓扑进行线程绑定和布局优化,从而减少缓存竞争和不必要的线程迁移。该框架运行于标准 Linux 环境,并利用系统内置监测与调度接口完成性能信息采集和线程控制,无需依赖专用硬件,具有较好的部署与移植能力。
实验基于 AMD EPYC 多核服务器处理器平台展开。结果表明,该框架将平均 L3 缓存未命中率从 62.71% 降低至 51.89%,CPI 从 2.35 降低至 2.02,线程迁移次数从 36902 次减少至 33339 次,有效改善了缓存局部性、程序执行效率和线程调度稳定性。
该研究为大容量缓存多核处理器中的线程调度与缓存资源协同优化提供了一种新的技术路径,使系统能够根据工作负载运行特征动态调整线程规模和线程放置方式,从而更加充分地利用多核处理器的计算与缓存资源。未来,团队将继续围绕面向3D缓存CPU的体系结构设计与性能优化开展研究,进一步探索大容量片上缓存、多核计算与运行时调度之间的协同优化机制。


